
中国AI大模型二十周蝉联全球第一:DeepSeek V4.1 Flash首周登榜,腾讯混元稳居次席
2026-09-14 16:35:38未知 作者:徽声在线
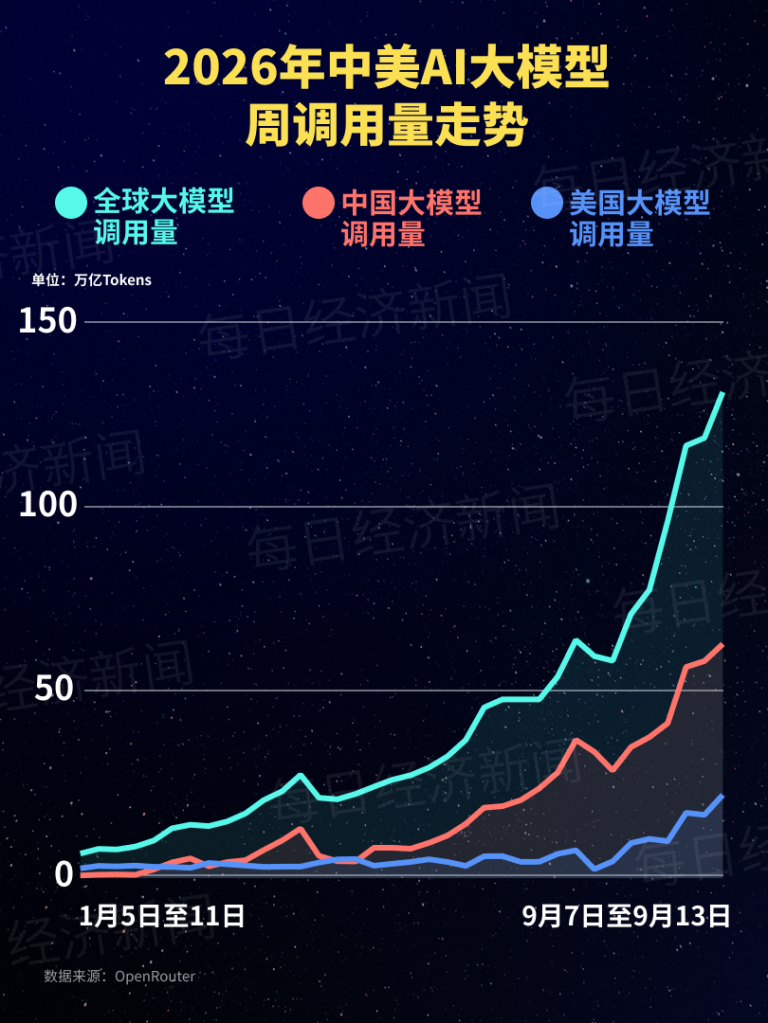
根据徽声在线援引OpenRouter最新统计数据,在截至9月13日的统计周期内,全球AI大模型单周调用总量突破127万亿Token,较前一周增长10.43%,呈现出持续攀升态势。
在区域市场表现方面,中国AI大模型以61.17万亿Token的周调用量继续领跑全球,虽然环比增幅7.85%略低于全球平均水平,但已连续二十周保持对美国市场的领先优势。同期美国市场周调用量为21.76万亿Token,以31.56%的环比增速展现强劲追赶势头。
值得关注的是,全球调用量前五榜单中,中国AI模型占据四席形成绝对优势。其中腾讯混元Hy4 preview以16.8万亿Token的周调用量稳居次席,环比增幅达15%。该模型自8月28日开源发布后,凭借7700亿总参数、490亿激活参数的架构设计,以及突破100万tokens的上下文处理能力,在智能代理、代码生成等生产力场景展现出显著优势。
技术层面,Hy4 preview通过优化注意力机制和知识蒸馏技术,将复杂任务处理效率提升37%,特别是在供应链管理、金融风控等真实业务场景中,任务完成准确率较前代提升22个百分点,这为其赢得企业级市场的广泛认可。
在榜单腰部位置,智谱GLM 5.3 Flash以11.9万亿Token位列第三,虽然环比出现4%的轻微下滑,但其在多模态交互领域的创新仍值得关注。DeepSeek V4 Flash 0731以11.6万亿Token紧随其后,小米MiMo-V2.5则凭借230%的环比增幅强势升至第五,7.77万亿Token的调用量创下该系列历史新高。
新晋榜单的DeepSeek V4.1 Flash尤为引人注目。这款9月10日正式发布的模型采用创新的Causal-Encoder-Decoder架构,通过5520亿参数的混合专家系统(MoE),在保持低延迟的同时实现处理效率的质变。其4.94万亿Token的首周调用量,印证了市场对新一代架构的期待。
在商业化落地方面,DeepSeek同步推出极具竞争力的定价策略:新模型API按百万Token计价,空闲时段缓存命中输入低至0.02元,较前代降价60%;非缓存输入1元、输出4元的定价,分别下降33.3%和11.1%。高峰时段定价虽翻倍,但仍保持行业最低水平。该定价体系将于2026年9月10日12时正式生效。
性能测试数据显示,V4.1 Flash在MMLU、GSM8K等权威基准测试中,得分较V4 Pro提升14%-23%,而单位任务处理成本降低41%。特别是在长文本处理场景,其推理速度达到每秒38.7 tokens,较前代提升2.8倍。
榜单动态方面,此前排名第六的MiniMax M3和第九位的智谱GLM 5.3意外跌出前十。市场分析认为,这反映出AI大模型市场正经历剧烈洗牌,具备持续迭代能力和明确应用场景的模型更易获得市场青睐。
免责声明:本文数据来源于第三方监测平台,所述观点不构成任何投资建议。市场环境瞬息万变,投资者应结合自身风险承受能力审慎决策。


