
无需过度担忧AI失控,眼前挑战更紧迫——对话科大讯飞刘庆峰:共筑AI长跑之路
2026-10-25 16:06:50未知 作者:徽声在线
人工智能领域的发展正以惊人的速度突破预期:今年8月,一项关于AI辅助筛选新抗原的个性化mRNA黑色素瘤治疗疫苗的三期临床试验结果公布,显示联合用药方案能将患者复发或死亡的风险降低近半。而到了10月,OpenAI更是公开了722份由其前沿模型生成的数学研究,这些研究触及了多项数十年未解的数学难题,展现了AI在科研领域的巨大潜力……
在此背景下,科学家、硅谷科技巨头以及一线研究人员纷纷发出AI治理的预警。比尔・盖茨在8月发表的长文中指出,即便是在最理想的情况下,迈向人工智能新时代的转型也将是人类历史上最为动荡的时期之一,其影响深远且复杂。
10月22日,科大讯飞董事长刘庆峰在接受《每日经济新闻》记者专访时表示,目前AI尚未具备真正的自我意识,公众所担忧的“彻底失控”情况尚缺乏现实依据,但未来是否会出现则难以预料。他强调,当前更应关注的是AI技术快速落地后,社会治理体系如何与之相适应的问题。
刘庆峰认为,随着AI在多岗位上的提效作用日益显著,未来5年至10年内,全社会所需的生产和生活资料可能仅需10%至20%的人参与生产即可。这将引发一轮劳动力分流和新价值创造的重塑,对社会保障体系构成严峻挑战。“这是一场需要全社会凝心聚力的长跑。”他如此形容。
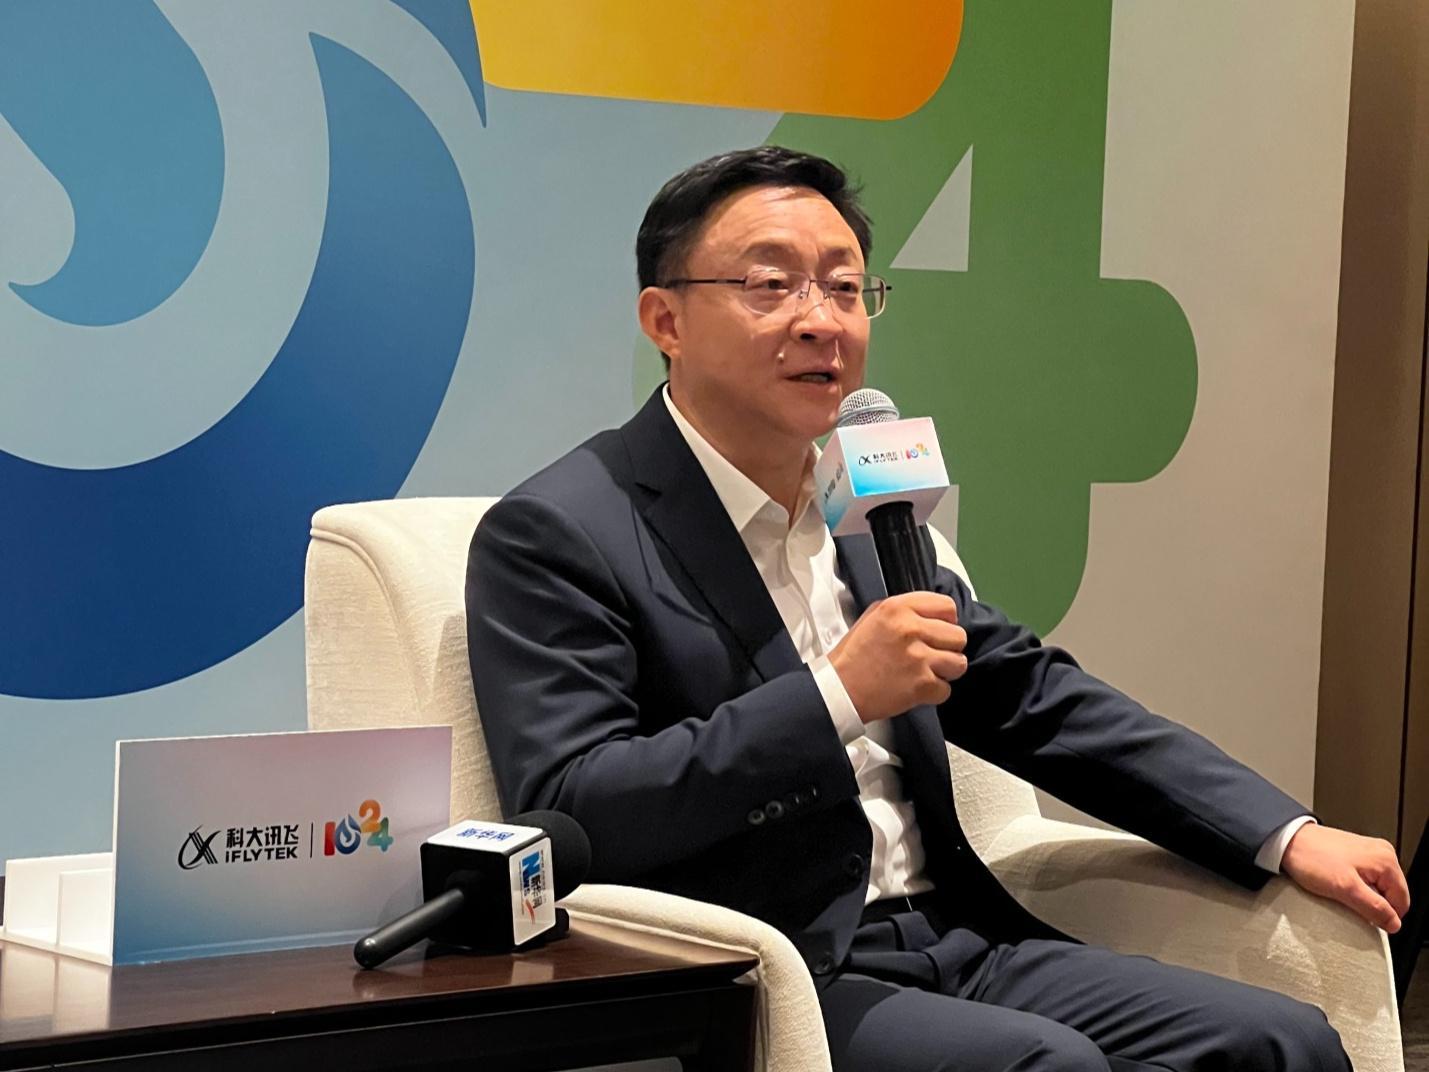
刘庆峰在接受采访(图片来源: 每经记者 李少婷 摄)
AI尚不具备“自我意识”的实质
AI的迭代速度之快,无疑使其成为人类历史上最具颠覆性的技术革命与产业革命之一。刘庆峰向记者表示,近期数百个数学研究问题被AI攻克,这一进展远超人们的预期。他分析指出,过去一年大模型训练底层方法并未取得重大突破,主要是模型规模扩大、训练数据体量增加以及高质量数据的积累推动了AI的发展。
刘庆峰提到,当前模型在查找、修复代码漏洞以及尝试攻破各类系统方面的能力不断增强。例如,近日全球广泛使用的服务器端编程语言PHP曝出两项高危安全漏洞,正是借助AI手段完成了漏洞可利用性的验证。(详情可查阅每经报道《PHP高危漏洞席卷全球,AI在网络安全攻防中发挥关键作用》)
他强调,一个超强的模型若没有应用场景的限制,可能会被用于黑客攻击、窃取银行商业机密等恶意行为。因此,为了防止模型应用的失控,社会治理必须与时俱进,加强监管和防范。
针对公众对AI是否具备自我意识的担忧,刘庆峰认为,目前AI尚不具备真正的自我意识。那些看似能够自主修改代码的AI,实际上是在人的指令下运行,其能力边界由人为定义。虽然AI可以实现情感计算,模拟人类情绪表达,但缺乏支撑真正自我意识的算法基础。不过,他也表示,未来AI是否会演化出自我意识,或是在持续沿用“大力出奇迹”的迭代路径后催生自我意识,目前尚难以判断。
社会保障体系面临AI挑战
在接受专访时,刘庆峰指出,当下最值得重视的社会治理议题是人工智能在多岗位快速提效后,社会保障体系如何适配调整。他认为,整个社会首先需要建立社会兜底保障体系,这是他在今年两会上的“一号建议”。没有兜底保障线,社会将面临诸多问题。
其次,刘庆峰认为需要重新定义社会管理逻辑。除了社保制度外,还可以考虑调整工作日和工时,如将工作日从5天调整为3天、每日工时从8小时缩短至4小时,以让更多人保有工作机会、拥有价值成就感。
此外,他强调需要快速定义出工作的社会价值和新的工作类型。未来,工作可能不再局限于现有的范围,每个人每天健身、唱歌唱得好等也可能成为获得收入的方式。
“从人工智能的进展来看,未来几年之内,我们现在所需要的所有的生产和生活资料,可能真的只需要10%到20%的人干就行了。”刘庆峰表示,这客观上将引发一次劳动力的分流和新价值创造的重塑。他认为,这件事情比模型具备自我意识、未来会不会出现失控更迫切,需要全社会共同面对和解决。
“这是一场凝心聚力的长跑。”刘庆峰再次强调,凝心聚力一定是基于人工智能建设美好世界的共同愿景。今天面对的是未来5到10年整个社会在这一场工业革命中的重塑,整个社会伦理和人文牵引非常关键。他认为,中国可能是全世界最有机会解决这个问题的国家,因为我们的社会治理有机会把这事做得比别人更好。
值得一提的是,10月23日,国务院办公厅发布了《关于适应人工智能技术发展助力构建就业友好型发展方式的意见》,其中明确指出要减缓人工智能应用对就业的替代影响,并稳慎把握人工智能在劳动密集型行业应用的范围、力度和节奏,以尽可能减少对从业人员的冲击。
推动全栈自主可控,国产算力是关键
刘庆峰还从中国AI产业发展的视角,阐释了“凝心聚力”的另一重内涵:实现全栈自主可控。他认为,这是中国AI产业在全球竞争中取得优势的关键。
刘庆峰在“2026科大讯飞全球1024开发者节”上演讲 (图片来源:公司供图)
他详细解释了全栈自主可控的四层能力:首先,算力底座要实现国产化,不仅要基于国产算力开展推理,更要依托国产算力完成模型的原生训练;其次是算法的全栈掌握,并具备持续迭代创新的能力;第三,数据层面要能够自主完成数据获取、清洗治理,构建自主的数据工程能力,而非单纯依靠外部数据做蒸馏;第四,具备面向行业场景的软硬一体化创新能力,形成从底层硬件、模型算法到数据治理、场景落地的完整闭环。
“只有在国产算力上训练出模型,才是真正的自主可控。”刘庆峰特别强调了“真正的训练”的重要性。他认为,只有这样,中国才能对全球输出自己的AI技术,实现模型协同、共同发展,从而摆脱“卡脖子”的风险。
刘庆峰坦言,现阶段国产算力芯片在显存带宽等指标上与海外主流芯片仍存在差距。此外,国产大模型训练生态尚不完善,行业多数厂商仅在国产硬件上跑推理,缺乏在训练中可共享的生态资源辅助。例如,完成一个复杂的数学任务,在N卡上可能一个月就能验证完成,但在国产算力上可能需要花费半年时间才能达到80%的准确率。
尽管如此,刘庆峰对未来充满信心。他认为,未来两年国产算力将与顶尖水平拉平,而人工智能的创新还远没有结束。如果三五年之内量子计算和现在的经典人工智能预训练方法结合,将有可能实现成千上万倍的算力提升,从根本上解决现在的算力焦虑问题。


