
陶哲轩揭秘AI真相:千亿模型背后的数学原理,高中知识足以驾驭
2026-10-15 23:47:48未知 作者:徽声在线
你知道吗?每次ChatGPT回应你的一个提问,它背后消耗的电量,足以支撑一个普通家庭度过大半天的时间。
然而,菲尔兹奖得主陶哲轩却指出,这个看似高深莫测的AI系统,其底层的数学原理,其实在高中数学课本中就能找到踪迹。
这并非玩笑话。陶哲轩深入剖析了大模型的内部结构,得出的结论令人惊讶:其核心仅依赖于两样基础的数学工具——微积分与矩阵乘法。
别急着划走,或许你觉得数学与你相距甚远,但读完这篇文章,当你再次面对“AI黑箱”、“神经网络玄学”等术语时,你将能泰然处之,心中自有底气。
接下来,让我们一同深入探讨这一话题。
模型训练的过程,其实与教小孩识别猫狗颇为相似。
当小孩第一次将猫误认为狗时,你会纠正他:“不对,这是猫。”模型亦是如此,它计算出答案后,会与真实结果进行比对,分析误差所在及大小。
此时,微积分便派上了用场。它的作用在于精确计算每个参数对误差的“贡献”程度。
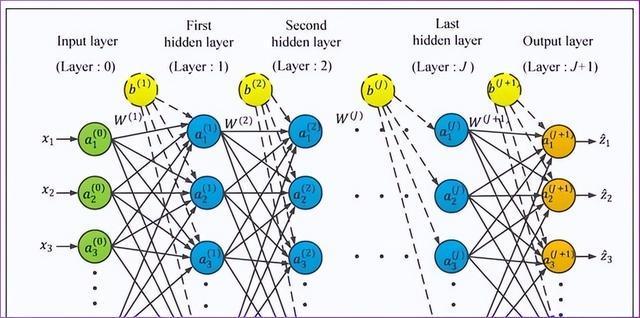
举个例子,假设你有一千个调节旋钮,模型答错了题。微积分能帮你确定,将第三个旋钮向左微调半圈、第七个旋钮向右调整一圈,能最大化提高下次答对的概率。这一过程被称为梯度下降,虽然名字听起来颇为高深,实则如同下山寻找最低点——沿着最陡峭的坡度下行,直至抵达谷底。
那么,矩阵乘法又扮演着怎样的角色呢?其原理更为直观。
你可以将模型想象为一个庞大的Excel表格,其中布满了密密麻麻的数字。当你输入一句话时,这句话也会被转化为一行数字。随后,这两个表格进行乘法运算,得出新的数字,再传递至下一层进行同样的操作,如此层层叠加,最终输出一个答案。
就是这么简单。
例如,当你询问“苹果手机好用吗”时,模型会先将这句话转换为一串数字向量,然后与第一层的参数矩阵进行乘法运算,得出中间结果,再继续与下一层矩阵相乘——如此重复数十甚至上百次,最终输出“苹果手机在系统和生态方面具有显著优势”的回答。
那么,模型是如何理解“苹果”既可能指水果也可能指公司的呢?这得益于矩阵乘法在计算过程中,会自动分析“苹果”这个词与周围词的关联度。若周围是“手机”、“iOS”等词汇,模型便会倾向于将其解读为科技产品;若周围是“甜”、“好吃”等词汇,则更可能将其视为水果。
所谓的注意力机制,听起来颇为高级,实则拆解开来,不过是两个矩阵相乘,计算词与词之间的关联权重,并进行加权求和而已。
至此,你或许会问:既然如此,为何大模型的研发如此艰难?
答案并不在于数学本身的复杂性,而在于规模的庞大。
一个拥有千亿参数的大模型,在进行一次前向计算时,所需的矩阵乘法次数堪称天文数字。在训练过程中,需要将海量数据反复输入模型,每一步都需计算梯度、调整参数,这一过程需重复数百万次甚至上亿次。
你或许可以用纸笔模拟一个小型模型,通过三层矩阵的手动调参,打造一个简易的聊天机器人,一个周末的时间便足够。然而,若要使其在真实场景中发挥出色,参数量、数据量、算力这三个要素均需大幅提升。当这些要素达到一定规模时,模型的效果便会自然显现。
这并非数学的胜利,而是工程实现的壮举。
因此,那些将AI描绘得神乎其神的科普文章,要么是作者自身未真正理解,要么是故意制造神秘感,让你觉得AI高不可攀。
陶哲轩的观点十分明确:AI的底层原理并不复杂。微积分负责优化调整,矩阵乘法负责计算输出,两者相辅相成,一个指引方向,一个得出结果。当模型陷入学习困境时,是微积分在寻找原因;当模型能够流畅对话、撰写文章时,则是矩阵乘法在默默支撑。
你真正需要关注的,并非AI背后是否隐藏着魔法,而是它在计算过程中何时会出错、为何会出错。
读完这篇文章后,若有人再告诉你“只有博士才能搞懂AI”,你可以自信地回应:在原理层面,高中数学基础便已足够。复杂的是规模、数据量以及算力成本——但这些只是资金和时间的问题,与智商无关。
想亲自体验一番吗?安装Python环境,运行几个矩阵乘法,编写一个简单的梯度下降调参示例,一个下午的时间,你便能亲眼见证模型从盲目猜测到逐渐准确的转变。
那一刻,你或许会与我一样,觉得所谓的人工智能,其实颇为实在,并无那么神秘莫测。


