
中国AI模型出海制胜法则:全球调用量霸榜背后的成本革命
2026-09-29 04:07:00未知 作者:徽声在线
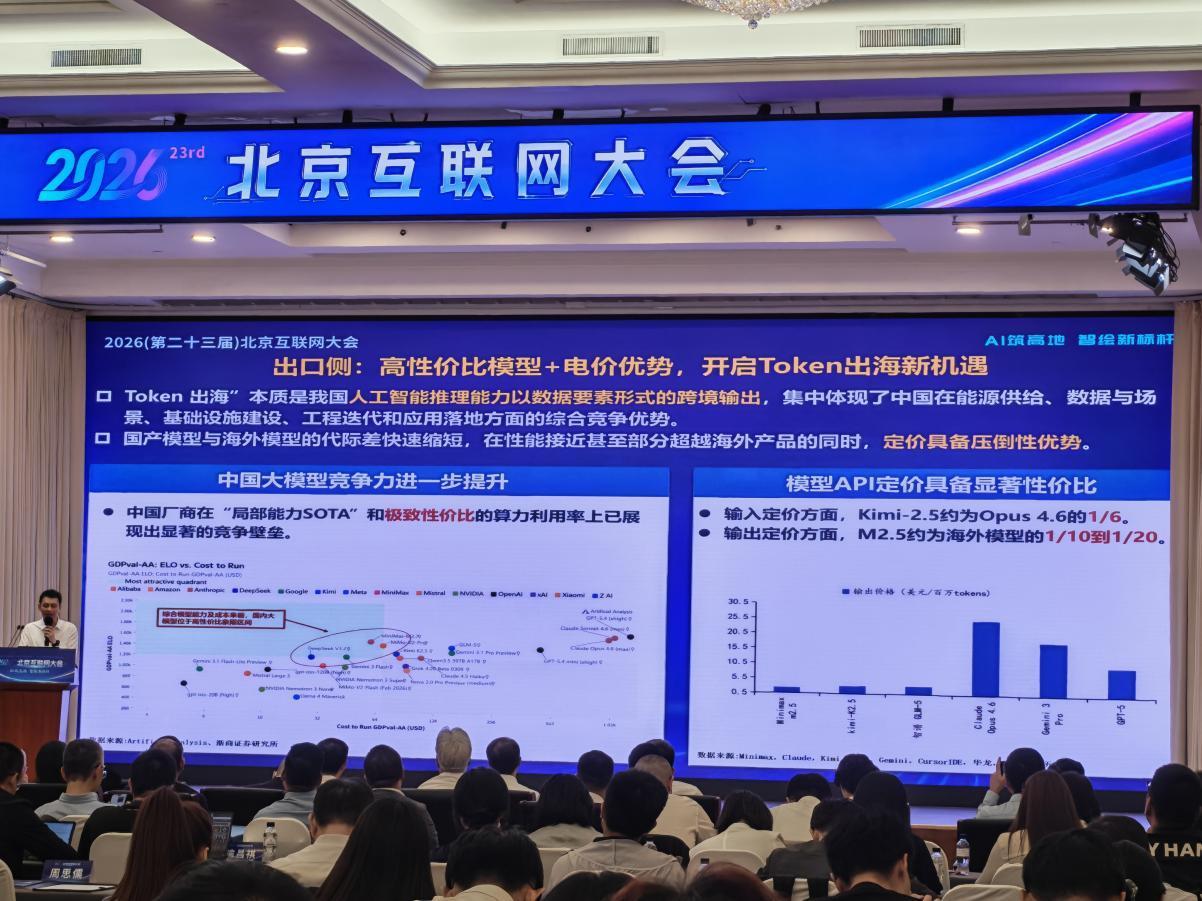
"当前,国产大模型与海外同类产品的技术代差正迅速缩小,在性能指标接近甚至部分超越国际领先水平的同时,中国模型在定价策略上展现出压倒性优势。"9月21日,中国信息通信研究院副院长敖立在'2026(第二十三届)北京互联网大会'上指出,Token(词元)的跨境流动实质是中国人工智能推理能力通过数据要素形式实现的全球化输出,这集中体现了我国在能源供给体系、数据资源储备、基础设施网络、工程迭代能力及商业落地场景等五大维度的综合竞争优势。
'2026北京互联网大会'现场实景 图片来源:徽声在线记者 温沐夏 摄
据《徽声在线》记者基于OpenRouter最新数据的深度测算,在9月14日至20日的统计周期内,全球AI大模型总调用量突破129万亿Token。其中中国AI大模型贡献了67.46万亿Token,环比增幅达10.28%;而美国同期调用量仅为14.21万亿Token,环比下降34.7%。这一数据对比显示,中国大模型的周调用量已达到美国的4.7倍,形成显著领先态势。
在全球化竞争中,极致性价比正成为中国大模型出海的核心竞争力。这种竞争优势的深层逻辑是什么?当全球AI产业竞争焦点从单纯参数规模转向算力效能与产业落地的综合较量,中国厂商如何将短期调用规模优势转化为长期稳定的全球市场占有率?这些问题亟待深入解析。
价格优势凸显:中国模型定价仅为海外同类1-2成
记者持续追踪发现,截至9月20日,中国大模型周调用量已连续21周超越美国,持续领跑全球市场。更值得关注的是,在全球调用量排名前五的模型中,中国产品占据四席:DeepSeek V4.1-Flash以15.8万亿Token的周调用量登顶榜首,环比激增219%;智谱GLM 5.3 Flash以14.1万亿Token紧随其后;腾讯混元Hy4 preview以12.5万亿Token位列第三;DeepSeek-V4-Flash-0731(正式版)则以9.44万亿Token排名第五。这组数据充分展现了中国模型在全球化竞争中的强劲势头。
敖立分析指出,中国大模型调用规模领先的关键因素之一在于API定价策略的显著优势。以具体案例来看,在输入定价方面,Kimi-2.5模型的价格约为海外Opus-4.6模型的1/6;输出定价方面,MiniMax M2.5模型仅为海外同类产品的1/10至1/20。瑞银证券的深度研究显示,中国模型的API平均定价仅为海外对标产品的10%-20%,同时仍能保持20%-40%的毛利率水平,这种定价策略既具有市场竞争力又确保了商业可持续性。
需要特别说明的是,Token单价下降并不必然导致单次任务总成本降低。第三方评测机构Artificial Analysis的测试数据显示,DeepSeek V4.1-Flash模型平均每项任务消耗约8.9万输出Token,较上一代DeepSeekV4-Flash-0731的6.2万有明显增加。该机构评价指出,新版本模型在输出内容上存在过度冗长(very verbose)的现象,这提示模型优化仍需在效率与质量间寻求平衡。
"能源供给是Token产业发展的基石。"敖立强调,电力成本通过算力供给链条传导至Token生产环节,最终决定着大模型服务的价格底线。据行业调研,在典型大模型的成本结构中,电力支出占比超过50%,部分场景甚至达到60%-70%,硬件折旧约占20%-25%,人工运维等成本占10%-15%。
算电协同创新:多维突破持续降低单Token能耗
从能源基础设施视角观察,我国智能算力规模的快速扩张为Token成本优化提供了坚实支撑。截至2026年6月,全国智能算力规模已达2185 EFLOPS,算力设施整体上架率提升至71.4%,建成52个万卡级智算中心。近两年,围绕国家算力枢纽节点建设的超70条算力大通道,使相关节点间网络性能提升10%,有效降低了数据传输成本。
在空间布局优化方面,能源资源禀赋深刻影响着Token产业的区域聚集。西部绿电富集区如甘肃、贵州、宁夏等地,凭借充足的风光水电力资源和低廉电价,成为大规模训练集群的首选地;而东部沿海地区则依托密集的应用场景需求,专注于推理服务与实时响应能力的建设。这种差异化布局实现了资源最优配置。
以甘肃庆阳为例,当地通过绿电聚合直供模式,将算力用电到户电价控制在每千瓦时0.398元。对比全国工业电价平均水平(0.6-0.7元/千瓦时),内蒙古、贵州等绿电富集区域可低至0.3-0.4元/千瓦时,新疆部分项目甚至达到0.32元/千瓦时。按生成100万Token耗电0.1-0.3千瓦时测算,我国西部算力电力成本仅为0.03-0.12元(每100万Token),较欧美地区低30%-50%以上,形成显著成本优势。
除电力成本外,工程效率提升同样是关键竞争力。性价比优势不仅源自低廉的电力和定价策略,更取决于算力利用效率。中国厂商在局部能力SOTA(当前领域内的最高水平)和极致性价比的算力利用率方面已构建起显著竞争壁垒。通过架构优化持续释放降本空间,国内模型在MoE架构稀疏度设计和推理目标函数优化上取得突破,使Agent场景下的响应速度和经济效益显著优于海外模型。
"未来算力协同的核心目标,就是降低每个Token的综合成本。"敖立指出,这需要通过绿电直供模式创新、推理效率持续优化、调度智能化升级、芯片能效提升等多维度突破,推动Token成本结构性下降。据行业预测,随着算电协同体系的完善,我国大模型单位Token成本有望在未来三年内再降40%。
当全球AI竞争从性能比拼转向性价比竞争阶段,"好用不贵"已成为打开国际市场的关键密码。敖立充满信心地表示:"未来中国大模型在海外市场的竞争力,将延续我国其他工业产品的成功路径,我们对此抱有极致期待。"这种信心既源于当前的成本优势,更建立在对技术创新持续投入的坚定信念之上。


