
中国AI大模型调用量持续领跑全球二十周:DeepSeek V4.1 Flash崭露头角,智谱GLM 5.3等模型排名变动
2026-09-15 05:05:41未知 作者:徽声在线
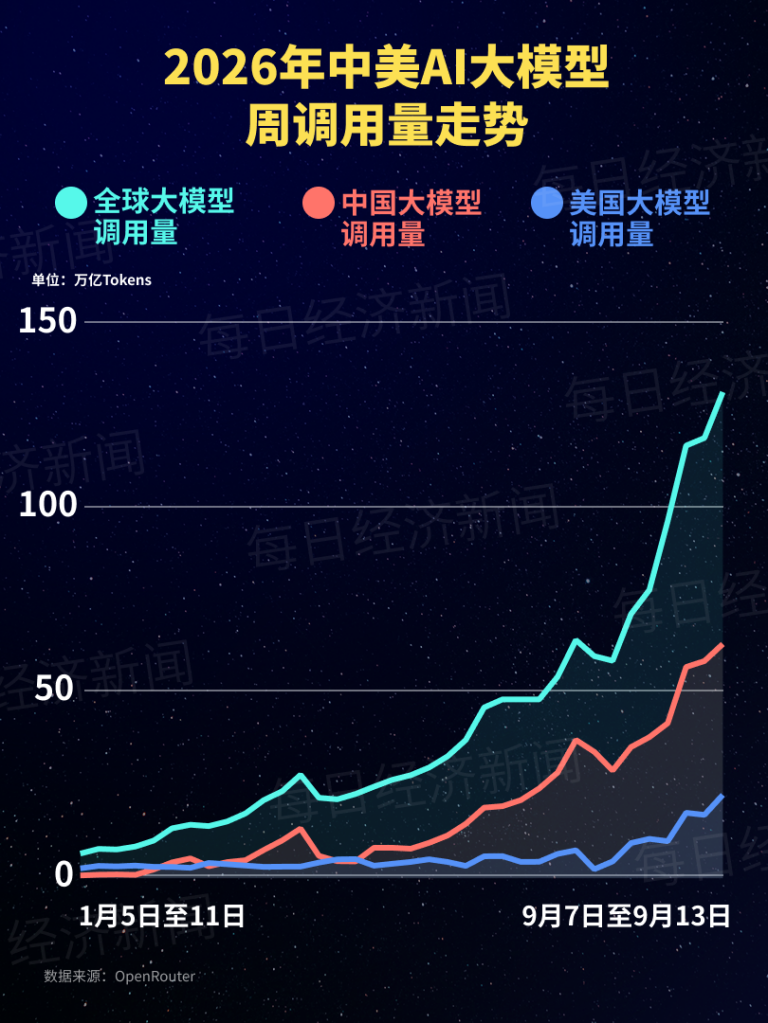
根据徽声在线援引OpenRouter最新统计数据,经过详细测算发现,在上周(即9月7日至9月13日期间),全球范围内AI大模型的调用总量达到了惊人的127万亿Token,相较于前一周,实现了10.43%的环比增长。
聚焦上榜的AI大模型,中国AI大模型在上周的调用量尤为抢眼,达到了61.17万亿Token,虽然增长率略低于全球平均水平,但仍保持了7.85%的稳健增长;相比之下,美国AI大模型在同期内的调用量为21.76万亿Token,却实现了高达31.56%的显著环比增长。值得一提的是,中国AI大模型的周调用量已经连续二十周超越美国,稳稳占据全球榜首的位置。
徽声在线进一步观察发现,在全球调用量排名前五的AI大模型中,中国AI大模型占据了四席之地。其中,腾讯混元Hy4 preview凭借出色的表现,位居第二,其周调用量高达16.8万亿Token,环比增长了15%。
腾讯混元Hy4 preview于8月28日正式发布,并慷慨开源,该模型总参数高达770B,激活参数为49B,上下文长度更是突破了1M的限制,特别针对Agent、Coding以及生产力场景进行了深度优化,显著提升了在真实业务场景中完成复杂任务的能力。
除了腾讯混元Hy4 preview外,智谱GLM 5.3 Flash也表现出色,位居第三,其周调用量达到了11.9万亿Token,尽管环比下降了4%;而DeepSeek V4 Flash 0731(即DeepSeek V4 Flash的正式版本)则紧随其后,位居第四,周调用量为11.6万亿Token,环比下降了6%;小米MiMo-V2.5则实现了跨越式进步,升至第五,周调用量高达7.77万亿Token,环比增长了惊人的230%。
此外,DeepSeek V4.1 Flash也成功登上榜单,排名第六,其周调用量达到了4.94万亿Token。该模型于9月10日正式发布,采用了全新的Causal-Encoder-Decoder(因果编码器—解码器)结构,是一个总参数量为552B的混合专家模型(MoE),展现了强大的技术实力。
在价格策略上,DeepSeek对V4.1 Flash的API定价进行了下调。按照每百万Token计算,空闲时段的缓存命中输入价格仅为0.02元,缓存未命中输入为1元,输出为4元;而在高峰时段,价格则分别为0.04元、2元和8元。这一新价格将于2026年9月10日12:00正式生效。
与DeepSeek V4 Flash同一时段的价格相比,V4.1 Flash在缓存命中输入方面的价格降低了60%,未命中输入的价格降低了约33.3%,输出的价格则降低了约11.1%,无疑为用户提供了更为实惠的选择。
据DeepSeek官方介绍,DeepSeek V4.1 Flash在性能、费用、速度以及任务总用时等多个指标上,均已全面超越了V4 Pro,展现了其卓越的技术进步和市场竞争优势。
然而,市场总是充满变数。值得注意的是,此前一周还排名第六的MiniMax M3以及排名第九的智谱GLM 5.3,在上周却意外跌出了榜单,这无疑为AI大模型市场的竞争格局增添了更多的不确定性。
免责声明:本文所载内容与数据均仅供参考之用,并不构成任何投资建议。在使用前,请务必进行核实,据此操作所产生的风险,需由使用者自行承担。


