
中国AI模型出海制胜法则:全球调用量霸榜背后的成本革命
2026-09-24 07:39:21未知 作者:徽声在线
"当前,国产大模型与海外同类产品的技术差距正以惊人速度缩小,在部分性能指标实现反超的同时,价格优势形成绝对碾压态势。"9月21日,中国信息通信研究院副院长敖立在'2026(第二十三届)北京互联网大会'上指出,Token跨境流动实质是中国AI推理能力通过数据要素形式实现的全球输出,这背后折射出我国在能源保障、数据资源、基建网络、工程优化及商业落地等维度的综合竞争力。
'2026北京互联网大会'现场实景 图片来源:徽声在线记者 温沐夏 摄
据《徽声在线》记者基于OpenRouter最新数据测算,9月14日至20日全球AI大模型总调用量达129万亿Token,其中中国模型贡献67.46万亿Token,环比增长10.28%;同期美国模型调用量仅14.21万亿Token,环比下降34.7%。这意味着中国模型的周调用量已是美国的4.7倍,且已连续21周保持全球领先地位。
在全球化竞争中,极致性价比成为中国AI模型破局的关键武器。这种竞争优势的底层逻辑是什么?当全球AI产业从参数竞赛转向算效比拼,国产模型如何将短期调用优势转化为可持续的全球市场统治力?这些问题亟待深度解析。
价格仅为海外1/5至1/10,中国模型重构全球AI定价体系
最新监测数据显示,截至9月20日,全球调用量前五名中四席被中国模型占据。其中DeepSeek V4.1-Flash以15.8万亿Token的周调用量登顶,环比增长219%;智谱GLM 5.3 Flash(14.1万亿)和腾讯混元Hy4 preview(12.5万亿)分列二三位。值得注意的是,DeepSeek-V4-Flash-0731正式版也以9.44万亿Token的调用量跻身前五。
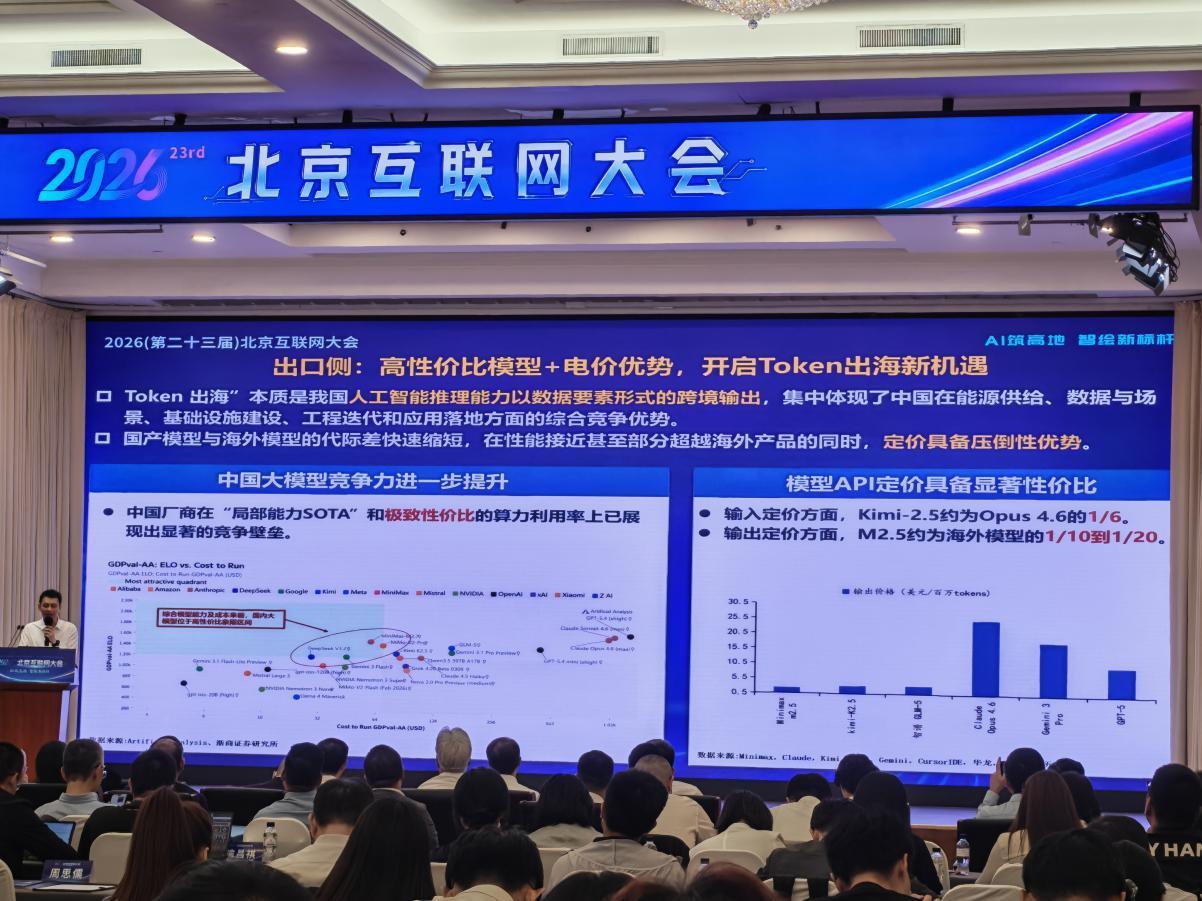
敖立分析指出,中国模型的核心竞争力在于API定价策略。以输入定价为例,Kimi-2.5的成本仅为Opus-4.6的1/6;输出环节MiniMax M2.5的价格更是低至海外模型的1/10至1/20。瑞银证券研究显示,中国模型API均价仅为海外对标产品的10%-20%,同时仍能维持20%-40%的毛利率水平。
不过低价策略并非没有代价。第三方机构Artificial Analysis评测发现,DeepSeek V4.1-Flash平均每项任务消耗8.9万输出Token,较前代产品增加43.5%。该机构特别指出其输出存在过度冗余问题,这反映出模型在追求性价比过程中面临的效率平衡挑战。
"能源成本是决定Token经济性的根本因素。"敖立强调,电力支出通过算力供给链传导至终端服务,直接划定了模型定价的底线区间。
据其拆解的成本模型显示,在典型大模型运营中,电力成本占比高达50%-70%,硬件折旧占20%-25%,人工运维等支出占10%-15%。这种成本结构决定了能源优化对模型竞争力的关键作用。
算电协同创新:中国模型的降本双引擎
从基础设施维度看,我国智能算力规模为成本优势提供了坚实支撑。截至2026年6月,全国智能算力总量达2185 EFLOPS,设施上架率71.4%,万卡级智算中心达52个。近两年新建的70余条算力大通道,使枢纽节点间网络时延降低10%,为算力高效调度创造条件。
在空间布局上,能源禀赋深刻影响着产业集聚。西部绿电富集区如甘肃、贵州、宁夏等地,凭借充足的风光水发电资源和0.3-0.4元/千瓦时的低价电力,成为模型训练的理想基地;而东部沿海地区则依托密集的应用场景,专注发展推理服务等高附加值环节。
以甘肃庆阳为例,当地通过绿电聚合直供模式,将算力用电价格控制在0.398元/千瓦时。对比我国工业电价平均0.6-0.7元/千瓦时的水平,内蒙古、贵州等绿电区域可再降低40%-50%。新疆部分项目电价甚至低至0.32元/千瓦时。按生成百万Token消耗0.1-0.3千瓦时计算,西部算力的电力成本仅为0.03-0.12元,较欧美同类服务低30%-50%。
除能源成本外,工程优化同样贡献显著。中国厂商在局部能力SOTA(领域最优)和算力利用率方面已建立技术壁垒,特别是在MoE架构稀疏度设计和推理目标函数优化上取得突破。这些创新使智能体场景下的响应速度和经济性全面超越海外竞品,形成独特的竞争护城河。
"算电协同的本质是降低单位Token的综合成本。"敖立指出,这需要从四个维度持续突破:推广绿电直供模式、优化推理算法效率、实现智能调度、提升芯片能效。通过这些创新,中国模型正在重构全球AI产业的价值链。
随着AI竞争进入性价比主导的新阶段,'高质低价'将成为中国模型征服全球市场的核心策略。敖立预测:"未来中国AI模型在海外市场的表现,将复制中国制造的崛起路径,通过极致性价比重新定义行业标准。"


