
AI集群规模扩大,算力利用率反降?华为灵衢互联重构AI计算新架构
2026-09-24 03:25:02未知 作者:徽声在线
近年来,AI行业在芯片性能的赛道上展开了激烈的角逐,单颗芯片的运算速度、算力指标以及制程工艺成为了衡量技术实力的关键指标。然而,随着大模型技术的飞速发展,特别是MoE(混合专家模型)、Agent(智能体)以及长上下文推理等技术的广泛应用,未来的算力竞争格局正在发生深刻变化。如今,算力的较量已不再局限于单颗芯片的峰值性能,而是转向了如何将海量的计算、存储和网络资源高效整合,形成强大的系统能力。在这一背景下,如何提升计算系统的有效算力利用率,成为了亟待解决的核心挑战。
“在传统的计算架构下,随着AI集群规模的持续扩大,资源利用率反而可能呈现下降趋势。以十万卡集群为例,其实际模型算力利用率仅能达到约20%,这意味着大量的计算资源并未真正投入到模型计算中,而是消耗在了等待通信完成的环节。”9月17日,在华为全联接大会2026的盛会上,华为常务董事、ICT BG CEO杨超斌如是说道。他进一步指出,随着10T参数大模型训练的深入,产生的海量中间数据已远超单卡内存的承载能力;而进入Agentic AI时代后,Agent与模型之间的交互频率更是高达每小时数百次,这无疑加剧了CPU、NPU、内存和存储之间的数据交换需求。
这一系列变化表明,当AI集群从千卡级别迈向万卡、十万卡乃至百万卡级别时,算力竞争已从单一计算单元的性能比拼,升级为整个计算系统的协同效率较量。这不仅要求解决“有多少算力”的问题,更需攻克计算、内存、存储和网络资源如何高效连接,以及如何让如此庞大的计算资源真正作为一个整体协同运作的难题。
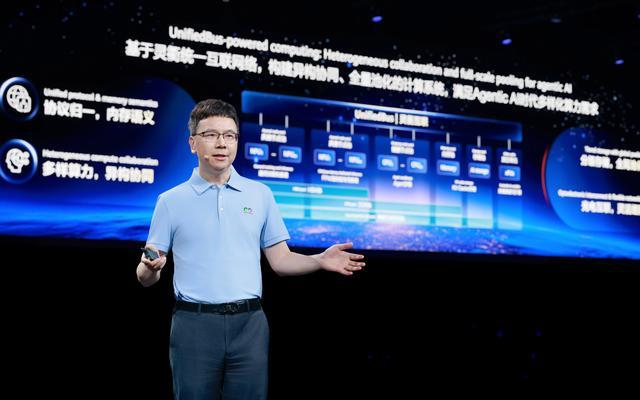
针对这一挑战,杨超斌在大会上系统阐释了华为面向Agentic AI的新计算架构。华为以灵衢互联为核心,构建了集群+超节点的新计算架构,将CPU、NPU、DPU、DDR、SSD等多种计算与存储单元进行统一互联和分级池化。这一创新架构实现了多样性算力的高效协同,能够灵活适应未来业务负载的变化,并支持新型异构算力的灵活扩展。与此同时,华为还发布了覆盖柜内、跨柜和集群的灵衢互联设备,以及基于灵衢的Agentic AI超节点集群及系列化一体机算力底座,为AI计算提供了强有力的支撑。
从“堆砌芯片”到重构计算系统
在AI集群的扩张之路上,最直接的方法莫过于增加计算卡。然而,当卡数扩展至一千张、一万张乃至十万张之后,新的问题随之浮现:每颗芯片虽具备强大的计算能力,却需不断与其他芯片交换参数和中间数据。若通信速度无法跟上计算速度,大量时间将耗费在数据传输和等待上,导致计算效率大打折扣。
华为副董事长、轮值董事长汪涛提供的一组数据令人深思:一个由8卡服务器组成的10万卡集群,在模型训练过程中,集群内通信时间竟超过训练时间的40%,严重制约了MFU(模型浮点算力利用率)的提升。而华为马尔可夫实验室的仿真结果则显示,在同样10万卡规模下,由4K规模超节点组成的集群相比传统8卡服务器组成的集群,MFU可提升至原来的2.75倍。汪涛强调,MFU每提升1个百分点,模型迭代时间可提前约3天,这对于加速AI技术的研发和应用具有重要意义。
因此,当集群规模进入十万卡甚至更大级别时,亟待解决的问题已不再是如何将更多计算卡“塞进”一个集群,而是如何让它们真正实现高效协同。
这正是华为提出新计算架构的出发点所在。在杨超斌的阐释中,灵衢(UnifiedBus)作为这套架构的核心互联技术,扮演着至关重要的角色。与传统服务器中CPU、加速器、内存、存储分别通过不同协议连接的方式不同,灵衢首先将十余种互联协议统一为一套协议,实现了互联的标准化和简化。在灵衢架构下,互联带宽从百GB级提升至TB级,RTT通信时延从7微秒压缩至2微秒,并支持超节点内全局内存统一编址,为数据的高效流动提供了有力保障。
然而,统一协议和提升带宽仅解决了“数据如何更快流动”的问题。在传统以单台服务器为资源边界的架构中,CPU、NPU、内存等物理资源通常按整机配置,部署后数量和配比相对固定。即便不同AI任务对CPU、NPU、内存的需求各异,计算资源也难以根据任务负载进行按需重组。这无疑限制了计算资源的灵活性和利用率。
而在灵衢架构下,CPU、NPU、内存、SSD等不同计算、存储和网络设备之间可以直接互联,实现去中心化平等访问。这意味着CPU和NPU能够根据实际计算任务进行更加灵活的资源配比,从而满足不同AI任务对计算资源的多样化需求。
这一变化在Agentic AI场景下尤为显著。传统大模型主要完成问答和内容生成等任务,而Agent则需要进行任务规划、工具调用和多轮执行等复杂操作。这意味着一项任务可能在CPU、NPU、内存和存储之间反复流转,对不同计算资源的需求也会不断变化。因此,如何根据任务需求灵活调配计算资源,成为了提升Agent性能的关键。
针对这一现状,华为提出了AF分离部署策略。Transformer模型主要由Attention(注意力机制)和FFN(前馈网络)等模块构成,但二者承担的任务和对计算资源的需求并不完全相同。其中,Attention主要负责处理不同Token之间的上下文关联,尤其随着上下文变长,对访存和数据交换的需求会持续增加;而FFN则承担大量特征变换和矩阵计算任务。过去,Attention和FFN通常在同一套计算资源中连续执行,导致计算资源无法得到充分利用。华为则通过分层分级Transformer硬加速技术,将二者解耦并分别部署到不同的算力单元,再根据各自的计算特点配置相应资源。这样一来,CPU和NPU不必再按照固定比例跟随服务器部署,而是可以根据不同业务、不同计算阶段的实际需求灵活组合,从而提升推理效率与资源利用率。
如果说AF分离解决的是“不同计算任务如何更灵活地使用算力”的问题,那么随着模型越来越大,灵衢还需要解决另一个更加基础的问题——计算过程中产生的海量数据究竟应该存放在哪里。
大模型参数量和上下文长度的不断增加,带来了一个直接的问题:数据“装不下”。尤其在推理阶段,KV Cache会随着上下文长度的增加迅速占用内存空间;而10T参数模型训练产生的中间数据,也进一步增加了单卡HBM的容量压力。这无疑对存储系统提出了更高的要求。
对此,华为提出了分级存储和全局池化的解决方案。通过不同介质之间的资源池化技术,扩展整个计算系统能够调用的存储空间。例如,DDR可以成为NPU的“第二内存”,为NPU提供额外的存储支持。杨超斌介绍称,在搜推广等业务中,这一架构可以降低业务时延,并使千亿级、数千维向量检索性能翻番;在10T大模型训练场景下,则可以降低模型对单卡HBM容量的要求,进一步提升整个集群的模型浮点算力利用率(MFU)。
由此,灵衢承担的角色也逐渐清晰起来:它并非简单地将更多计算卡连接在一起,而是试图通过统一互联技术,将原本相对分散的CPU、NPU、内存、存储和网络重新组织为一个高效协同的计算系统。通过提出分级存储和全局池化的理念,灵衢进一步扩展了整个计算系统能够调用的存储空间,让整个超节点能够以更接近“一台计算机”的方式运行,从而提升计算效率和资源利用率。
从柜内到集群:灵衢构建三级互联体系
当一个超节点继续向数千卡、数万卡乃至百万卡级别扩展时,仅仅解决超节点内部的互联问题显然是不够的。如何让这套架构跨越机柜甚至数据中心级集群继续扩展呢?这成为了华为需要攻克的下一个难题。
对此,华为进一步将灵衢从超节点内部的互联技术扩展为一套分层分级的互联系统。该系统分别覆盖柜内、跨柜和集群三级互联,旨在解决计算规模不断扩大过程中不同距离、不同层级的数据交换问题,并最终支持从单柜到百万卡集群的弹性扩展。这一创新架构为AI计算的大规模部署提供了有力支持。
在单个机柜内部,服务器之间距离较短但芯片密度越来越高,传统线缆连接方式变得愈发复杂且难以管理。为此,华为推出了柜内灵衢互联刀片技术,通过光电互联方式减少大量线缆连接。据华为介绍,柜内灵衢互联刀片可以实现“零电缆、零电路损耗”的目标。以4096超节点为例,采用该技术可以节省196公里铜缆的使用量,大大降低了布线成本和复杂性。
当一个超节点从单柜扩展至多个机柜之后,距离变长、数据量增加对互联技术提出了更高的要求。此次发布的跨柜灵衢互联设备支持176个端口,每端口带宽达到1.6T,单机实现280T全光互联能力,RTT时延最低达到2微秒。这一设备可以将分布在不同机柜中的计算资源继续连接为一个更大的计算系统,为AI计算的大规模部署提供了有力保障。
除了互联设备之外,华为还开始围绕这套架构构建一个更完整的算力系统。会上发布的基于灵衢的Agentic AI超节点集群由鲲鹏950、昇腾960超节点、OceanStor M900记忆存储以及星河UBG交换机组成。该集群实现了多样算力的协同与分级资源池化,为AI计算提供了强大的性能支持。
值得注意的是,这套架构并非只面向百万卡级超大型AI基础设施。华为同时将灵衢技术向更小规模的计算系统延伸,推出了从1卡到8卡的系列化一体机以及鲲鹏昇腾模组。其中,Atlas 650E风冷服务器通过双机灵衢直连技术可以实现16个NPU免交换互联功能,使两台服务器“像一台运行”般协同工作。该服务器还能够继续平滑扩容形成小型超节点,使中小企业也能够在本地运行万亿参数大模型,降低了AI技术的门槛和应用成本。
然而,在硬件创新之外,生态建设仍然是国产算力规模商业化过程中不可或缺的一环。如何构建一个开放、协同的生态系统,吸引更多的开发者、企业和高校参与进来,共同推动AI技术的发展和应用,成为了华为需要思考的重要问题。
会上,杨超斌公布了华为在生态建设方面的最新进展。自去年8月华为宣布灵衢开源开放以来,来自企业、高校的众多开发者热情参与、踊跃贡献代码和资源。目前社区月活开发者已达5200多人,业界累计合入超428万行代码。CANN社区已跃升为中国开源项目活跃度第一的社区。同时,昇腾与DeepSeek Harness、OpenCode、openJiuwen等开源框架协同合作,打造了智能管理、推理加速、安全框架等Agent插件化组件并全量开源;已联合50多家客户、伙伴及高校打造了26个行业算子库,并与90多家主流开源社区合作,助力伙伴快速完成行业Agent开发与IT系统对接。这些举措为AI技术的普及和应用奠定了坚实基础。
展望未来,杨超斌表示:“华为将坚持系统级创新理念不动摇,构筑系列化算力底座产品体系;同时坚持开源开放策略不动摇,联合客户、伙伴和开发者共建生态体系;为世界提供更多元化、更具竞争力的AI计算解决方案选择。”


