
中国AI大模型调用量二十周领跑全球:DeepSeek V4.1 Flash新晋上榜,多款模型排名变动
2026-09-22 15:47:40未知 作者:徽声在线
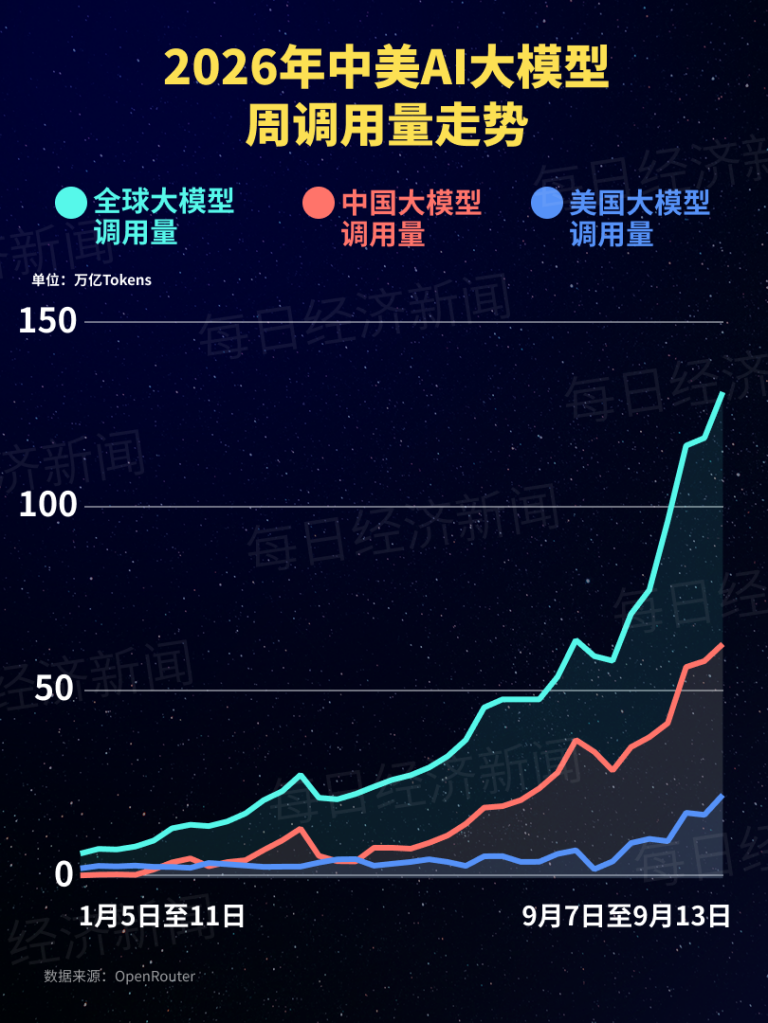
据徽声在线援引OpenRouter最新统计数据推算,在刚刚过去的统计周期(9月7日至9月13日)内,全球人工智能大模型的总调用量达到127万亿Token,较前一周增长10.43%,呈现出持续攀升的态势。
在纳入统计范围的AI大模型中,中国AI大模型表现尤为亮眼,当周调用量高达61.17万亿Token,环比增长7.85%;而同期美国AI大模型的周调用量为21.76万亿Token,环比增长31.56%。值得关注的是,中国AI大模型的周调用量已连续二十周超越美国,持续领跑全球市场。
徽声在线分析发现,在全球调用量排名前五的AI大模型中,中国产品占据四席。其中,腾讯混元Hy4 preview以16.8万亿Token的周调用量稳居第二,环比增幅达15%,展现出强劲的增长势头。
作为8月28日正式发布并开源的新一代模型,Hy4 preview拥有770B的总参数和49B的激活参数,上下文处理长度突破1M大关。该模型针对Agent、编程与生产力场景进行了深度优化,显著提升了在复杂业务场景中完成任务的能力,为其调用量的快速增长奠定了坚实基础。
在排名中,智谱GLM 5.3 Flash位列第三,当周调用量达11.9万亿Token,但较前一周下降4%;紧随其后的DeepSeek V4 Flash 0731(即DeepSeek V4 Flash正式版)以11.6万亿Token的调用量排名第四,环比下滑6%;小米MiMo-V2.5则以7.77万亿Token的调用量升至第五,环比激增230%,成为当周增长最快的模型之一。
值得一提的是,DeepSeek V4.1 Flash新晋上榜并排名第六,当周调用量达4.94万亿Token。该模型于9月10日正式发布,采用创新的Causal-Encoder-Decoder(因果编码器—解码器)架构,是一个总参数量为552B的混合专家模型(MoE),在模型结构设计上实现了重要突破。
在定价策略上,DeepSeek对V4.1 Flash的API定价进行了下调。按照每百万Token计算,空闲时段的缓存命中输入价格为0.02元、缓存未命中输入为1元、输出为4元;高峰时段则分别为0.04元、2元和8元。新价格体系将于2026年9月10日12:00正式生效。
与V4 Flash同一时段的价格相比,V4.1 Flash的缓存命中输入价格降低了60%,未命中输入价格下降约33.3%,输出价格减少约11.1%,价格优势进一步凸显。
据DeepSeek官方介绍,经过全面优化,DeepSeek V4.1 Flash在性能表现、费用控制、处理速度和任务总用时等关键指标上均已超越V4 Pro,为用户提供了更具竞争力的选择。
需要关注的是,此前一周排名第六的MiniMax M3和排名第九的智谱GLM 5.3未能继续保持在榜单之中,显示出AI大模型市场竞争的激烈程度。
免责声明:本文内容与数据仅供参考,不构成投资建议,使用前请核实。据此操作,风险自担。


