
万亿级大模型“瘦身”进PC:明略科技端侧AI的破局之道
2026-09-21 23:11:46未知 作者:徽声在线
在过去的数年中,AI领域的主旋律一直是追求模型的规模扩张与能力提升。然而,随着模型逐渐融入Agent和复杂工作流程,一个新挑战浮现:模型能力越强,消耗的Token数量也急剧增加,推理成本成为AI技术广泛应用不可回避的财务考量。
这一现实促使AI产业的关注点从单纯追求“模型还能扩展到何种规模”,转向“这些能力应如何高效部署”。云端依旧是核心战场,但端侧AI正孕育着新的发展机遇:设想一下,如果最前沿的模型不再局限于数据中心,而是能够无缝融入普通用户的办公设备,将会开启怎样的新篇章?
这并非简单的模型“瘦身”过程。它要求对模型架构进行精细取舍,对硬件配置进行深度适配,并对推理框架进行革新设计。
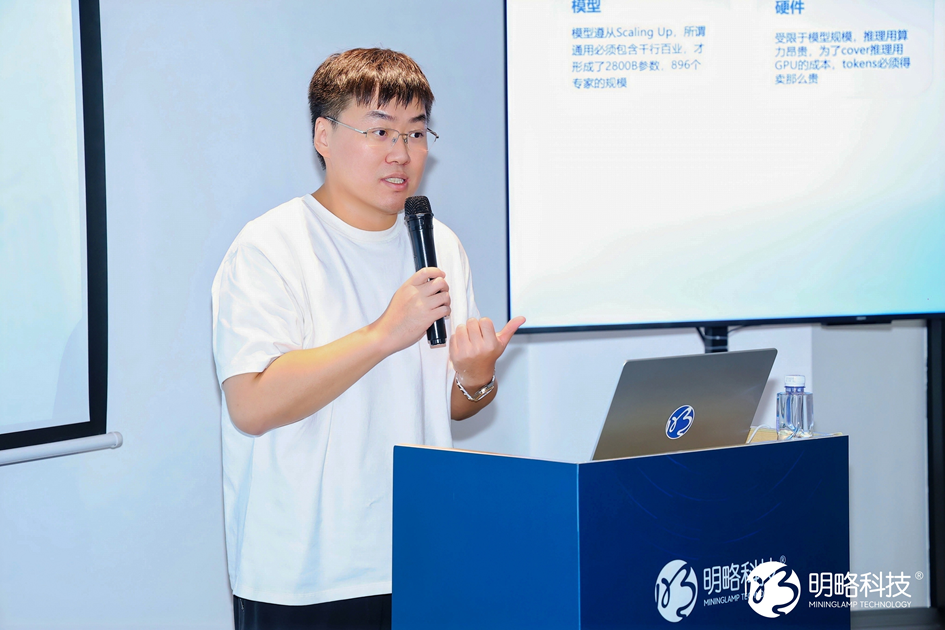
明略科技副总裁、多模态首席科学家赵晨旭在内部战略研讨会上,深入分享了端侧模型创新的系统性思考。基于模型的Scaling Out策略,他提出一个关键问题:如何将最前沿的AI能力,从云端的数据中心,真正迁移至每个人的办公设备上。这或许标志着端侧AI从“支持小模型运行”向“支持大模型运行”的一次重大范式转变。
图片来源:明略科技
以下为精选内容概述:
AI能力的不断增强,背后是Token消耗和算力成本的持续攀升。换个视角思考,假设有一天,如Fable 5这样的顶级模型完全开源,将会引发怎样的变革?
这一设想并非遥不可及。当前,已有接近这一水平的开源模型涌现,如Kimi K3。我们近期基于明略科技构建的大规模Web Agent综合评测基准WebRetriever进行测试,K3在最难的协议三上已位居榜首。
这意味着,“是否存在接近顶尖闭源模型能力的开源模型”这一问题已有了初步答案。随之而来的新问题是:即便模型开源,我们能否有效利用它?
以K3为例,其完整MoE参数规模高达2.8万亿,激活参数也达千亿级别。对于普通企业和个人而言,即便模型开源,也并不意味着能够轻松应用。因此,未来AI行业或将迎来一个有趣的变化:从一味追求模型规模扩大,转向思考如何将强大的模型进行缩小、拆解,并最终部署到个人电脑上。
这也是我们探讨端侧模型创新的出发点。
过去致力于“模型扩容”,如今聚焦于“模型应用”
图片来源:明略科技
回顾大模型的发展历程,始终围绕三个核心要素展开:模型、硬件和推理框架。
在模型层面,遵循Scaling Law原则,不断追求参数增加、数据丰富和训练算力提升,以增强模型能力。为何模型需要如此庞大?原因在于它们需满足全球各行各业用户的多样化需求。一个通用模型既要服务金融客户,又要支持研发人员,还要处理代码、搜索、办公、科学计算等任务。为覆盖如此广泛的数据分布和任务需求,模型自然需要更多专家模块。
因此,一个模型拥有数千亿参数、数百甚至上千个专家模块,并非无的放矢。
然而,对于具体个人或企业而言,真的需要如此多的专家模块吗?
答案或许是否定的。金融从业者可能更关注金融领域的能力;研发人员则更需要Coding、Web Search或AI for Science等相关能力。对于具体用户而言,真正需要的可能只是大模型中的十几个或几十个专家模块。
若从个体或企业的实际工作场景出发,真正需要的可能只是模型的一部分能力。那么问题变为:能否从庞大的通用模型中,提取出真正属于我的那部分能力?
若模型因此变小,第二个问题随之而来:它能否在普通PC上运行?若PC的算力、显存和内存不完全匹配,是否可通过新的硬件和推理框架实现运行?
因此,当前面临的问题已与几年前不同。过去的问题是:如何扩大模型规模?现在的问题则是:如何将足够强大的模型真正部署到用户身边?若模型、硬件和推理框架这三个问题都能得到解决,Token ROI的逻辑也将发生深刻变化。
如何通过Scaling Out策略在缩小模型的同时保留专家能力?
提到缩小模型,大家首先想到的是蒸馏技术。但此次我们分享的是一种新思路——Scaling Out。
Scaling Down,即传统蒸馏,是在保持模型通用性的前提下缩小模型规模。它牺牲的是单个专家模块的能力,但尽可能保留原有的数据分布和专家分布。
而Scaling Out的思路则有所不同。它愿意牺牲一部分数据分布和专家分布,但希望保留下来的专家模块能力尽可能不受影响。
图片来源:明略科技
可将原大模型想象为一个巨大的圆。Scaling Down是缩小整个圆,而Scaling Out则是从这个大圆中提取与你真正相关的几个小圆。
这一过程的关键不再仅仅是模型压缩,而是首先回答一个问题:对于特定用户、企业或业务场景,哪些专家模块真正有用?
因此,Scaling Out的第一步并非训练,而是观察用户。我们需要根据用户身份、工作内容和实际任务,构建相应的数据集。然后将这些任务放入足够大的模型中运行,通过模型原有的路由机制观察:完成这些任务时,到底激活了哪些专家模块。例如,Coding任务可能经常激活某些Coding专家模块,Web Search则可能激活其他专家模块。
经过大量任务运行后,我们可以统计不同专家模块的使用率、特异性,以及哪些任务必须由几个专家模块组合完成。最终得到的不是一个“通用模型”,而是一个针对具体用户、企业任务的最小专家模块集合。
原模型可能拥有万亿参数、千万个专家模块,经过筛选后,可能只需其中一部分。然后针对这个新的专家模块集合重新设计路由、进行训练和微调,最终得到一个更适合具体场景部署的模型。
因此,Scaling Out真正想解决的不是单纯的“模型压缩”,而是:一个通用大模型中,有多少能力其实是我不需要的?能否只带走我需要的能力,同时尽可能保留这些能力的原有性能?
这也是我们认为Private AI可能出现的重要技术基础。未来,一方面可能继续有人追求越来越强、越来越通用的AGI模型;另一方面,也可能出现越来越多面向企业和个人的Private AI。它们不需要拥有全世界的知识,而是只需拥有自己真正需要的那部分专家能力。模型变小后,如何让普通办公电脑运行起来?
模型变小只是第一步,接下来更现实的问题是硬件。
当前的消费级PC处于一个有趣的状态:有些机器算力足够,但显存不足;有些机器内存充足,但缺少运行大模型的算力。因此,我们常看到普通电脑运行4B、8B模型已不稀奇,但若告诉大家一台普通办公PC也能运行120B级别的模型,并能断网完成复杂的Coding任务,可能会令人感到惊讶。
我们已在实际设备上验证了这一点。我们在一台普通电脑上部署了SOTA大模型,并将明略自研的人和Agent智能工作平台Octo与OpenAI的Codex接入该环境,实现了断网状态下模型在本地完成任务。
这反映了一个重要变化:端侧AI的门槛正从“是否拥有GPU”逐渐转变为“能否有效组织现有设备的计算和存储资源”。
一台本地办公电脑能否真正运行大尺寸模型,取决于模型、推理框架与硬件三者能否协同配合。围绕这一方向,明略科技也在持续探索,并将于后续发布最新进展。
端侧AI的价值,最终要回归到“为何值得在本地运行”
若模型、硬件和推理框架这三个问题都得到解决,端侧AI的价值将不仅限于“技术上可行”,它将直接改变AI的经济账。
以往,我们使用AI,本质上是在租用别人的GPU。我们向云端发送请求,云端完成推理,然后按Token付费。但若越来越多的模型能直接在个人电脑上运行,那么AI就可能从“持续租用算力”转变为“一次性拥有计算能力”。
同时,端侧AI还意味着安全和循环经济两个现实价值。
一是安全和断网能力。对于对数据安全有特殊要求的企业而言,模型不能联网,也不适合将数据发送给外部云端模型。端侧AI天然提供了一种新选择:模型、数据和任务均可留在本地。
二是内存利旧。如今,大家手中的许多设备仍拥有可观的存储资源。过去,这些资源难以直接参与大模型推理,但通过新的模型架构和推理框架,它们开始有机会成为AI基础设施的一部分。将最前沿的AI能力从云端带到每个人身边
过去,AI行业一直在追求Scaling Up:模型越来越大,参数越来越多,算力越来越强。这一路线仍将继续。但与此同时,我们认为可能出现另一条路线——Scaling Out。
不再要求每个人都拥有完整的通用大模型,而是从最强的基础模型中提取真正属于自己的那部分专家能力;然后再解决两个问题:如何让它运行在普通硬件上,以及如何以足够低的成本运行。
因此,从模型到硬件,再到推理框架,实际上是在解决同一个问题:如何将最前沿的AI能力从云端的数据中心真正带到用户的办公设备上。
以往讨论端侧AI时,更多是在讨论“小模型”。但未来的端侧AI未必等于小模型。它更可能意味着:模型可以很强,但只运行你真正需要的那部分能力;模型可以很大,但不需要全部放入显存;设备可以很普通,但能够组织CPU、GPU、内存、SSD乃至外部算力。
最终目标不是让每个人拥有一台超级计算机,而是让我们今天正在使用的办公设备,逐渐具备运行最前沿AI能力的可能性。
关于明略科技
明略科技(2718.HK),自2006年成立以来,已成为中国领先的具备自研模型能力的Agentic Service企业。2025年,作为"全球Agentic AI第一股"成功登陆港交所。公司曾两度荣获吴文俊人工智能科学技术奖,多次入选Gartner、IDC相关报告,拥有2400余项技术专利及500余项软件著作权。近年来,多个AI模型在全球权威榜单上取得领先成绩。依托20年的技术积累,明略科技已服务135家财富世界500强企业、约2100家品牌客户及超24万家企业用户,覆盖零售、消费品、汽车、3C等多个行业。


