
中国AI大模型调用量持续领跑全球:DeepSeek V4.1 Flash崭露头角,智谱GLM 5.3等模型排名变动
2026-09-19 14:54:00未知 作者:徽声在线
根据徽声在线援引OpenRouter最新发布的统计数据,经过详细测算发现,在上周(即9月7日至9月13日期间),全球范围内AI大模型的总调用量达到了惊人的127万亿Token,与前一周相比,环比增长了10.43%,显示出AI技术的持续火热与广泛应用。
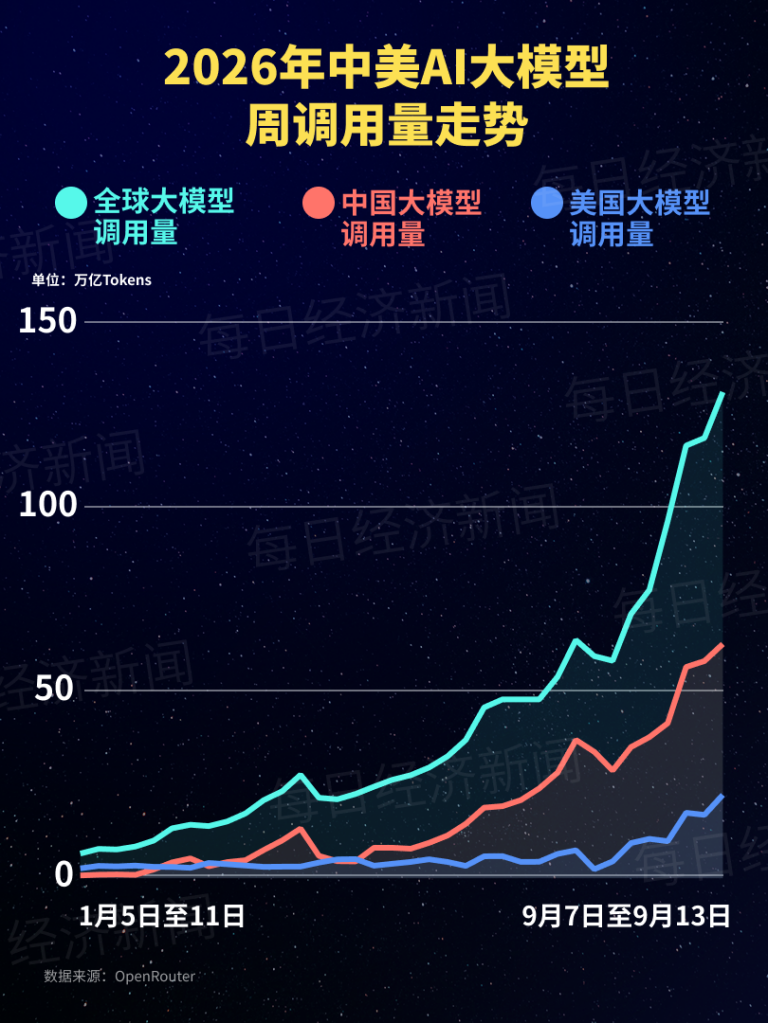
在上周上榜的众多AI大模型中,中国AI大模型的表现尤为抢眼,周调用量高达61.17万亿Token,虽然环比增长幅度为7.85%,略低于全球平均水平,但这一数字依然彰显了中国在AI领域的强大实力。值得一提的是,中国大模型的周调用量已经连续二十周超越美国,稳稳占据全球榜首的位置。
徽声在线进一步分析发现,在全球调用量排名前五的AI大模型中,中国占据了四席之多。其中,腾讯混元Hy4 preview凭借出色的性能表现,位居第二,其周调用量达到了16.8万亿Token,环比增长了15%,显示出强劲的增长势头。
腾讯混元Hy4 preview于8月28日正式发布并开源,该模型拥有总参数770B、激活参数49B的庞大规模,上下文长度更是突破了1M的限制。它重点面向Agent、Coding与生产力场景进行了优化,显著增强了在真实业务场景中完成复杂任务的能力,为用户提供了更加高效、便捷的AI服务。
在排名中,智谱GLM 5.3 Flash紧随其后,位居第三,其周调用量达到了11.9万亿Token,尽管环比下滑了4%,但依然保持着较高的调用量水平。而DeepSeek V4 Flash 0731(即DeepSeek V4 Flash的正式版)则位居第四,周调用量为11.6万亿Token,环比下滑6%。此外,小米MiMo-V2.5也表现出色,升至第五位,周调用量达到了7.77万亿Token,环比增长了惊人的230%,成为上周的一匹黑马。
值得一提的是,DeepSeek V4.1 Flash也成功登上了榜单,排名第六,其周调用量达到了4.94万亿Token。该模型于9月10日正式发布,采用了全新的Causal-Encoder-Decoder(因果编码器—解码器)结构,是一个总参数量为552B的混合专家模型(MoE),为用户提供了更加先进、高效的AI解决方案。
在价格方面,DeepSeek也进行了相应的调整,下调了V4.1 Flash的API定价。按照每百万Token计算,空闲时段的缓存命中输入价格为0.02元、缓存未命中输入为1元、输出为4元;而在高峰时段,这些价格则分别为0.04元、2元和8元。新的价格政策将于2026年9月10日12:00正式开始生效。
与之前V4 Flash同一时段的价格相比,缓存命中输入的价格降低了60%,未命中输入的价格降低了约33.3%,输出的价格也降低了约11.1%,这无疑将进一步降低用户的使用成本,提升AI技术的普及程度。
据DeepSeek官方介绍,DeepSeek V4.1 Flash在性能、费用、速度和任务总用时等关键指标上,已经全面超越了V4 Pro,为用户提供了更加优质、高效的AI服务体验。
然而,在上周的榜单中,也有一些模型的表现不尽如人意。此前一周排名第六的MiniMax M3和排名第九的智谱GLM 5.3就跌出了榜单,显示出AI领域的竞争之激烈和变化之快速。
免责声明:本文所包含的内容与数据仅供参考之用,并不构成任何投资建议。在使用前,请务必进行核实,并自行承担操作风险。


